claude.aiの過去の会話を分析して、使い方の改善点まで出る客観的なレポートを作る
Claude Codeの /insights を、claude.aiの会話向けに作り直しました。直近100会話を1件ずつ評価して、どの会話でなぜつまずいたか、何を変えればいいかまで出す方法と、貼るだけで試せる依頼文を紹介します。
はじめに
Claude Codeの /insights を、claude.aiの会話向けに作り直して実行してみました。claude.aiには標準の振り返り機能reflectがありますが、こちらのほうが一段深い気づきが得られました。
reflectは、どんな話題で、いつ、どんな種類の作業にClaudeを使ったかを見せてくれます。ただ、私が知りたかったのは「どの会話で、なぜつまずいたのか」と「明日から何を変えればいいのか」でした。
この記事では、作り直した方法の設計と、実際に出た結果を紹介します。最後に、claude.aiのチャットに貼るだけで同じことができる依頼文も載せています。
元ネタ:Claude Codeの /insights
/insights は、2026年2月にClaude Codeに加わったコマンドです。直近30日のセッションを分析し、インタラクティブなHTMLレポートを作ります(解説記事)。
レポートには次の要素が入っています。
- 統計:セッション数、メッセージ数、アクティブ日数など
- 要約:うまくいっていること、つまずき、すぐ試せる改善、踏み込んだ改善の4つ
- グラフ:日別の活動、ツールの使用分布、セッションごとの満足度など
- つまずきの分析:実際のセッションの具体例つき
- CLAUDE.mdへの追記提案:そのまま貼れるルール
仕組みの要は、セッションごとの評価です。Haikuが各セッションを読み、目標の達成度やつまずきを評価します。その結果を集計してレポートにまとめ、評価はキャッシュされるので、2回目以降は新しいセッションだけを分析します。
reflectとの違い
違いの中心は、会話を1件ずつ評価してから集計する点です。そのため、気づきごとに件数と、該当する会話そのものを示せます。
| 観点 | reflect | この方法 |
|---|---|---|
| 始め方 | 設定画面から生成 | チャットで依頼文を送る |
| 対象期間 | 過去1・3・6・12か月 | 直近100会話(私の場合は約10日分) |
| 分析の枠組み | 4D AI Fluency Framework(委任・説明・見極め・責任) | /insightsに合わせたトピック・種別・つまずき |
| 気づきの根拠 | 全体の傾向と、協働の仕方の例 | 気づきごとの件数と、該当する会話へのリンク |
| 提案の形 | Projectを始めるなどの実践的な提案 | 個人設定やプロジェクトの指示にそのまま貼れる文面 |
| 出力 | 設定画面のダッシュボード | 評価データ入りのHTMLページ |
| 次回以降 | 期間を選んで再生成 | 前回の評価を読み戻し、新しい会話だけ分析 |
reflectの内容はAnthropicの発表をもとにしています。reflectは長い期間をすぐ見渡すのに向き、この方法は短い期間を深く掘って、何を変えるかまで決めるのに向いています。置き換えではなく、併用するのがよいと思います。
claude.ai版の設計
/insightsの要素を、claude.aiで使える仕組みに1つずつ置き換えました。
| 要素 | Claude Code版 | claude.ai版 |
|---|---|---|
| 分析する記録 | ローカルのセッションログ | 過去チャットの取得機能が返す、会話の要約と抜粋 |
| 対象範囲 | 直近30日 | 直近100会話 |
| 会話ごとの評価 | Haikuが評価 | チャットのClaudeが評価 |
| キャッシュ | ローカルのファイル | レポートのページにJSONで埋め込み |
| 言語別の内訳 | プログラミング言語 | トピック別の内訳 |
| 設定の提案 | CLAUDE.mdへの追記 | 個人設定とプロジェクトの指示への追記 |
| 出力 | ローカルのreport.html | 共有するまで自分だけが開けるページ |
30日ではなく100会話にした理由:私は1日に8件ほど会話するので、30日分だと約300件になります。過去チャットは1回に20件までしか取得できず、取得と評価に時間がかかりすぎるため、件数で区切りました。
会話ごとの評価項目:各会話に次の7つを付けます。
- トピック
- 種別:一問一答、深掘り、調査・分析、やり方・設定、計画・意思決定、制作
- 推定発話数
- 使ったツール
- 持ち出した成果物
- つまずき:問い返しで終了、意図の取り違え、文体の往復、情報が見つからない、応答が未完
- 推定満足度
満足度は規則で推定します。解釈の取り違えがあれば「不満の兆候」、問い返しや未完で終われば「不明」、3往復以上か成果物があれば「成果・深掘りあり」、それ以外は「単発で完了」です。
キャッシュの代わり:評価データをレポートのHTMLに埋め込みました。次回はページのリンクを渡すと、Claudeがページを読み戻し、前回より新しい会話だけを評価して集計し直せます。
やってみた結果
9月20日から10月1日までの100会話を分析しました。推定発話は225回、1会話あたり2.25回で、ツールを使った会話は30件でした。
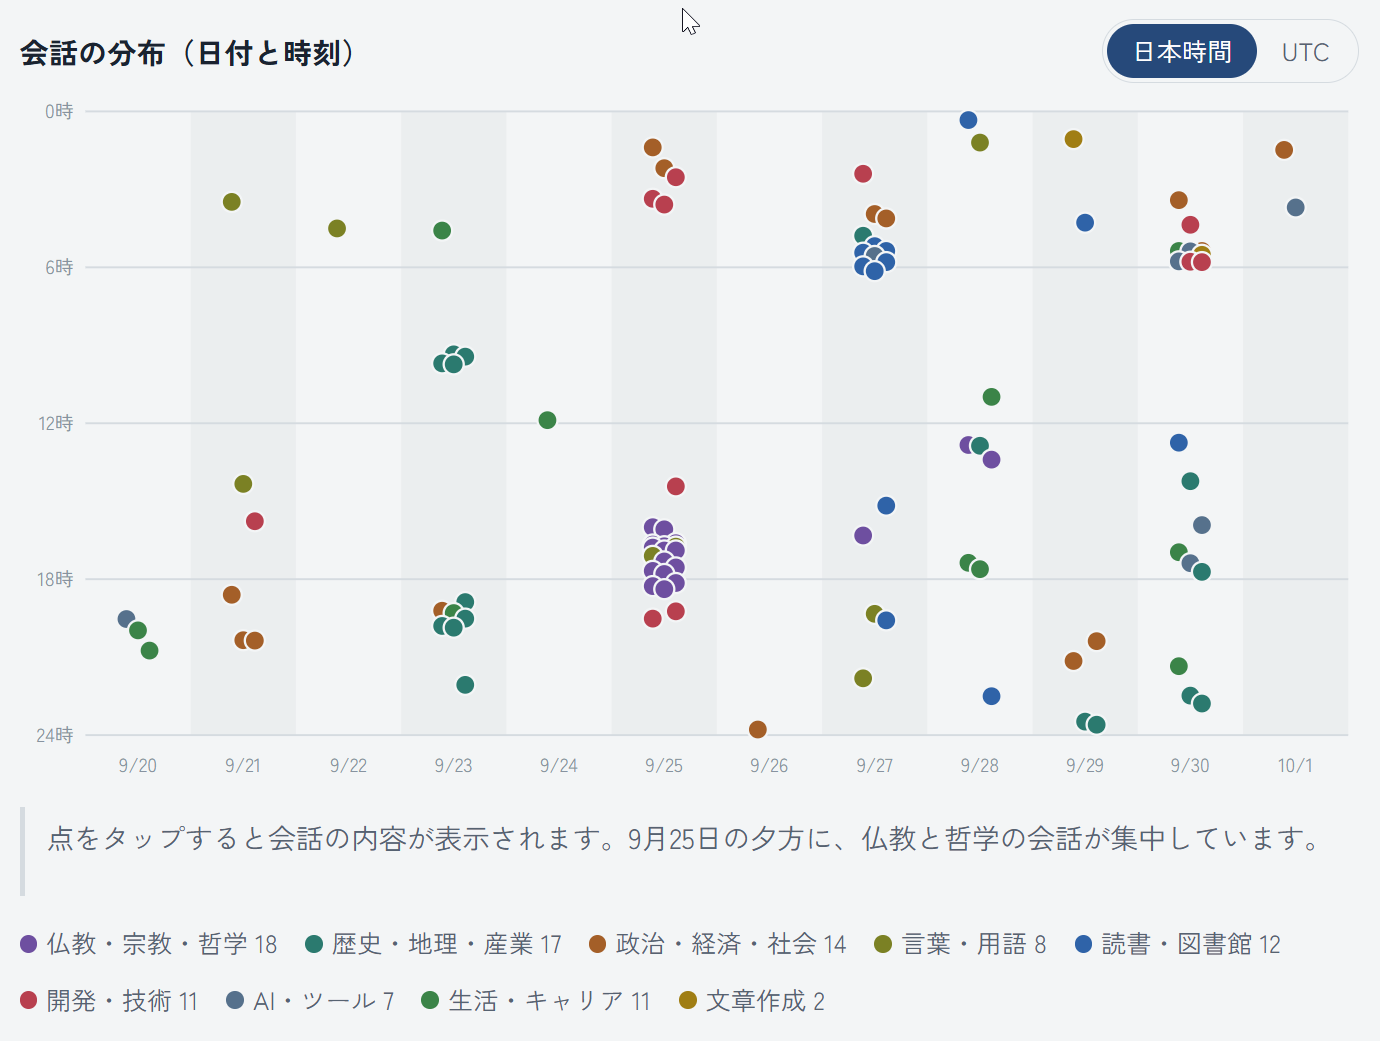
特に役に立った気づきは次の3つです。
前提を書かない技術の質問が、問い返しで止まっていた
ブラウザのメモ機能、オンボーディング用のライブラリ、起動時の画面の名称など、6件の質問が、Claudeの問い返しや解釈違いで止まったまま終わっていました。知識の質問は短く聞いても答えが変わりませんが、環境によって答えが変わる質問では、1行の前提がないと往復が1回増えます。
実は私は、文脈を渡すことの大切さをテーマにした記事を構想していました。その本人が、同じつまずきを6回していたことになります。
テーマ学習が、会話ごとに分かれていた
9月25日は約2時間半で17件の会話を開き、うち15件が仏教・宗教・哲学でした。話題が変わるたびに新しい会話を開いていたため、縁起や無我はそれぞれ少なくとも4つの会話で説明し直されていました。レポートは、テーマごとにプロジェクトを作ることを提案していました。
うまくいった流れも、時刻つきでわかった
図書館の所蔵がWeb検索では確認しきれなかった直後に、カーリルの図書館MCPを接続していました。約35分後には、愛知県内15の図書館システムで蔵書を比較しています。足りない結果を道具を足して解決した流れが、会話のリンクつきで示されたのは新鮮でした。
そのまま貼れる提案
レポートの最後には、個人設定に貼れる文面が出てきます。1つ目のつまずきに対する提案は次のとおりです。
前提や用語の解釈が複数ありうる質問(画面上の名称、使っている環境で答えが変わる技術的な質問など)では、最も可能性の高い解釈を採用し、その解釈を冒頭の1行で明示してから答える。問い返しだけで回答を終えない。
やり方
claude.aiのチャットに、下の依頼文を貼るだけです。事前に次の3つを確認してください。
- 設定で、過去のチャットの検索と参照がオンになっている
- コードの実行とファイルの作成がオンになっている(HTMLのレポートを作るため)
- プロジェクトの外の新しいチャットで実行する(プロジェクト内では、そのプロジェクトの会話だけが対象になります)
claude.aiの過去の会話を分析して、Claude Codeの /insights のような振り返りレポートを作ってください。

【対象】
・過去チャットの取得機能で、直近100会話を20件ずつ取得する。

【会話ごとの評価】
各会話に次の項目を付ける。
・トピック(会話の内容から4〜10種類に分類)
・種別:一問一答/深掘り/調査・分析/やり方・設定/計画・意思決定/制作
・推定発話数
・使ったツール
・持ち出した成果物
・つまずき:問い返しで終了/意図の取り違え/文体の往復/情報が見つからない/応答が未完
・推定満足度:取り違えがあれば「不満の兆候」、問い返しや未完で終われば「不明」、3往復以上か成果物があれば「成果・深掘りあり」、それ以外は「単発で完了」

【レポートの構成】
1. 統計:会話数、推定発話数、日数、1日あたりの会話数、2往復以上の割合、ツールを使った会話数、成果物の数
2. 要約:うまくいっている使い方、主なつまずき、すぐ試せる改善、より踏み込んだ使い方
3. 取り組んでいること:4〜5の領域と件数、各2〜3文の説明
4. グラフ:日付×時刻の分布、日別と時間帯別の件数、トピック・種別・ツール・つまずき・満足度の内訳。日本時間とUTCを切り替えられるようにする
5. 使い方の傾向:2〜3段落
6. うまくいったこと/つまずいたところ:それぞれ件数と、根拠の会話へのリンクを付ける
7. 個人設定とプロジェクトの指示にそのまま貼れる追記提案:根拠も添える
8. 設計と制約、会話ごとの評価の一覧

【出力】
・1つのHTMLページにして公開する。
・評価データはページ内にJSONで埋め込み、次回はそのページを読み戻して新しい会話だけを追加で分析できるようにする。
・健康、家族、お金などの個人的な話題は、トピック名だけで扱い、具体的な内容は書かない。
2回目からは、作られたページのリンクを渡して「インサイトを更新して」と頼むだけです。前回より新しい会話だけが追加で分析されます。
注意点と限界
便利ですが、公式機能ではないぶん、次の点は割り引いて読む必要があります。
- 評価の多くは会話の全文ではなく、自動で作られた要約に基づいています。発話数と満足度は推定です。
- グラフの時刻は会話の最終更新時刻です。始めた時刻とは限りません。
- プロジェクト内の会話は対象外です。プロジェクトで進めている作業の振り返りにはなりません。
- 取得と100件の評価、HTMLの生成を1回で行うので、完了までに時間がかかります。
- 評価するのはClaude自身です。私のレポートではClaudeの解釈違いも「つまずき」として挙がっていましたが、自己評価である点は意識しておくべきです。
- ページは共有するまで自分だけが開けますが、会話のタイトルや内容が載ります。人に見せる前に中身を確認してください。
まとめ
reflectは、使い方の全体像をすぐ見渡せる便利な機能です。一方で、会話を1件ずつ評価してから集計すると、「どの会話で、なぜつまずき、何を変えるか」まで具体的になります。
私の場合は、前提を書かずに聞く癖と、テーマ学習の分断が見つかり、個人設定とプロジェクトで直すべき点がはっきりしました。長い期間はreflectで眺め、直近はこの方法で深掘りする、という使い分けがよさそうです。